Patchright를 두고 굳이 Camoufox로 옮겨갈 이유가 있을까. Chromium을 계속 쓸 수 있고, 익숙한 Playwright 코드도 상당 부분 가져갈 수 있다. 브라우저 자동화를 하겠다고 Firefox 빌드와 지문 설정까지 신경 써야 하는지, 먼저 그쪽이 의문이었다.
쿠팡처럼 자동화 접근이 까다로운 서비스를 생각하면 어느 쪽이 더 잘 뚫리는지부터 궁금해진다. 나 역시 그 질문에서 출발했다. 그런데 두 프로젝트의 설명을 읽을수록 조금 다른 부분이 눈에 들어왔다. 통과했다는 서비스 이름은 많이 나와 있었지만, 그 설명만으로 내가 만들 자동화가 계속 동작할지는 알 수 없었다. 같은 도구를 썼다는 사실보다 어떤 브라우저를 어떤 상태로 실행했는지가 더 중요해 보였다.
그래서 이번에는 성공했다는 체크 표시보다 소스를 먼저 보기로 했다. Patchright가 줄이려는 흔적은 무엇이고, Camoufox는 왜 브라우저 자체를 수정하는지 궁금했다. 옮겨갈 이유가 있다면 그 차이 안에 있어야 한다고 생각했다.
Patchright를 그대로 써도 되는 이유
Patchright의 출발점은 이해하기 어렵지 않다. Playwright가 Chromium을 제어하면서 드러내는 흔적을 드라이버 쪽에서 줄인다. 별도의 지문을 정교하게 만들어 Chrome 위에 덮어씌우기보다, 실제 Chrome을 사용하면서 불필요한 자동화 신호를 덜 만드는 쪽이다. 공식 Node.js 예제도 Chrome, 화면이 있는 실행, 영속 프로필을 권장한다.
import { chromium } from 'patchright';

const context = await chromium.launchPersistentContext(
  './profiles/crawler',
  {
    channel: 'chrome',
    headless: false,
    viewport: null,
  },
);

try {
  const page = await context.newPage();
  await page.goto('https://example.com');
} finally {
  await context.close();
}
Chrome이 설치되어 있다는 전제의 코드다. 여기에 출처를 알 수 없는 User-Agent나 sec-ch-ua 헤더부터 추가할 필요는 없다. 브라우저는 Chrome인데 헤더는 다른 버전의 Chrome을 주장하고, 운영체제까지 다르게 보이게 만들면 오히려 내가 설명해야 할 변수가 늘어난다. 이미 Chromium에 맞춰 작성한 코드가 많다면 이 정도 구성에서 시작할 수 있다는 것은 분명한 장점이다. 프로필은 개인용 Chrome과 분리하고, 같은 디렉터리를 여러 프로세스가 동시에 쓰지 않도록 해야 한다.
내부에서 눈에 띄는 부분은 Runtime.enable이다. 이 명령은 CDP의 Runtime 관련 이벤트 보고를 활성화한다. Patchright의 초기화 패치는 일반적인 Chromium 초기화 과정에서 이 호출과 기본 binding 등록 일부를 제거한다. 브라우저가 자동화 도구와 주고받는 방식에 손을 대는 것이지, 페이지에서 navigator.webdriver만 false로 바꿔놓는 것은 아니다.
그렇다고 CDP를 쓰지 않는다는 뜻은 아니다. 필요한 평가에는 여전히 Runtime.evaluate 같은 명령을 사용한다. 조사한 배포 코드에는 WebView에 한정된 Runtime.enable 복구 경로도 남아 있었다. 어떤 호출을 평소 초기화에서 피하는지 봐야지, 명령 이름 하나를 프로젝트 전체에서 금지했다고 이해하면 안 된다. 디버깅하겠다고 CDP 세션을 하나 더 열어 같은 이벤트를 켜버리는 것도 이 차이를 흐리게 만든다.
Closed Shadow DOM을 다루는 방식도 흥미로웠다. Patchright는 페이지의 attachShadow를 가로채 모든 root를 open으로 바꾸는 대신, CDP의 DOM.describeNode에 pierce: true를 주고 닫힌 root를 찾아 resolve하는 경로를 갖는다. 이미 생성된 컴포넌트 내부를 locator로 다룰 수 있다는 점은 유용하다. 다만 챌린지 안의 버튼을 찾는 것과 서버가 그 세션을 받아들이는 것은 별개의 일이다. DOM에 접근할 수 있다는 이유만으로 Akamai까지 해결했다고 말할 수는 없다.
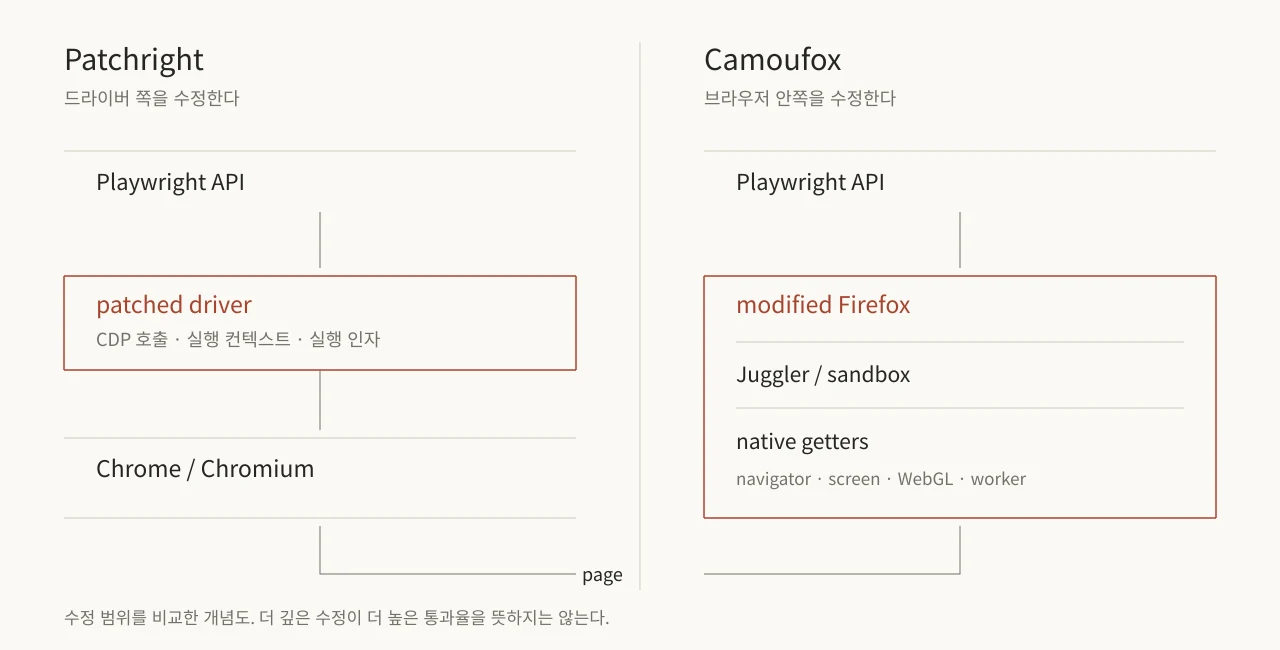 이 정도만 보면 Patchright를 버릴 이유는 딱히 없다. 문제는 익숙한 API가 있다고 해서 그 아래의 동작까지 Playwright와 같지는 않다는 데 있었다.
화면에는 있는데 코드에서는 보이지 않을 때
예를 들어 페이지가 window.__APP_STATE__에 상품 정보를 저장했다고 하자. 화면에도 상품이 보이고 DOM 속성에도 ID가 들어 있는데, page.evaluate()로 전역을 읽으면 값이 나오지 않을 수 있다. 데이터를 늦게 읽어서도, 페이지에 데이터가 없어서도 아닐 수 있다.
Patchright는 기본 평가에 격리된 실행 컨텍스트를 사용한다. 페이지가 실행하는 JavaScript와 자동화 코드가 실행되는 세계가 나뉘어 있는 것이다. DOM에는 접근하지만 페이지의 전역 변수까지 그대로 공유하지는 않는다. 내부의 Page.createIsolatedWorld 호출을 보고 나면 이 차이가 이해된다.
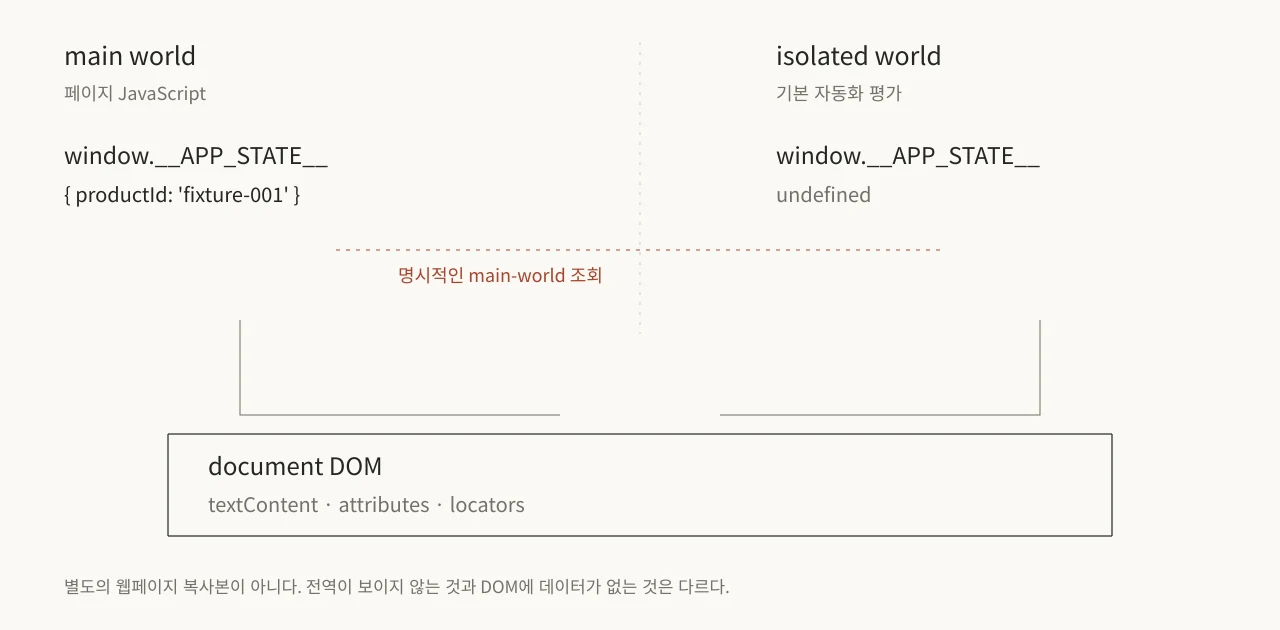
페이지의 전역을 읽으려면 main world를 명시적으로 선택해야 한다.
// patchright / patchright-core 1.64.2 기준.
// 페이지가 __APP_STATE__를 정의한 경우를 가정한다.
const isolated = await page.evaluate(
  () => window.__APP_STATE__ ?? null,
);

const main = await page.evaluate(
  () => window.__APP_STATE__ ?? null,
  undefined, // arg
  undefined, // options
  false,     // isolatedContext
);
마지막 false의 위치도 확인할 필요가 있었다. 조사한 1.64.2의 Page.evaluate는 pageFunction, arg, options, isolatedContext 순서다. Locator.evaluateAll은 options 자리가 없어 세 번째 인자로 받는다. 문서의 ...를 대충 넘기고 어느 메서드든 세 번째에 넣으면 된다고 생각하기 쉽지만, 실제 배포 패키지의 타입 선언은 그렇지 않았다. 프로젝트의 실행 컨텍스트 테스트에서도 main world를 선택하는 호출을 볼 수 있다.
이런 차이는 수집 코드를 작성할 때 바로 영향을 준다. DOM 속성으로 읽을 수 있는 값을 굳이 페이지 전역에서 찾다가 실패할 수 있고, 반대로 페이지 전역이 필요한데 계속 격리 세계에서만 찾을 수도 있다. 나는 가능한 부분은 locator로 읽고, 페이지가 가진 상태나 함수를 직접 다뤄야 하는 부분만 main world로 좁히는 편이 낫다고 생각한다. 전체 자동화의 격리를 한꺼번에 풀 필요는 없기 때문이다.
여기서 한 가지 더 조심할 것은 ‘격리’를 별도의 웹페이지 복사본으로 이해하는 일이다. JavaScript 전역과 실행 환경이 분리된다는 설명이지, 자동화가 수정한 DOM은 실제 페이지에 영향을 주지 않는다는 뜻이 아니다. 클릭 결과나 DOM 변경, 네트워크 요청과 타이밍까지 페이지에서 사라지는 것도 아니다.
설정을 추가했는데 다른 곳이 달라진다
더 신경 쓰였던 것은 addInitScript였다. 스텔스 예제를 찾아보면 브라우저가 뜨자마자 이것저것 덮어쓰는 코드가 자주 나온다. 브라우저가 보고하는 값에만 눈이 가기 쉽다. 그런데 Patchright에서는 그 함수를 호출하는 것 자체가 다른 조건을 만들 수 있었다.
README에는 초기화 스크립트를 route를 통해 HTML에 주입한다는 설명이 남아 있다. 하지만 조사한 드라이버 생성기와 patchright-core@1.64.2 배포 코드의 일반 등록 경로는 다음과 같았다.
await this._client.send('Page.addScriptToEvaluateOnNewDocument', {
  source: initScript.source,
  worldName,
  runImmediately,
});
이 부분만 보면 CDP의 새 문서 스크립트 등록이다. 그렇다고 route가 사라진 것은 아니었다. 클라이언트의 addInitScript는 여전히 installInjectRoute()를 부르고, 내부에 **/* route와 document 응답 가로채기 경로가 남아 있다. request interception은 HTTP 캐시 정책에도 연결된다. 스크립트 등록 방식이 바뀌었다는 사실과 네트워크에 영향을 주는 코드가 남았다는 사실을 함께 봐야 했다.
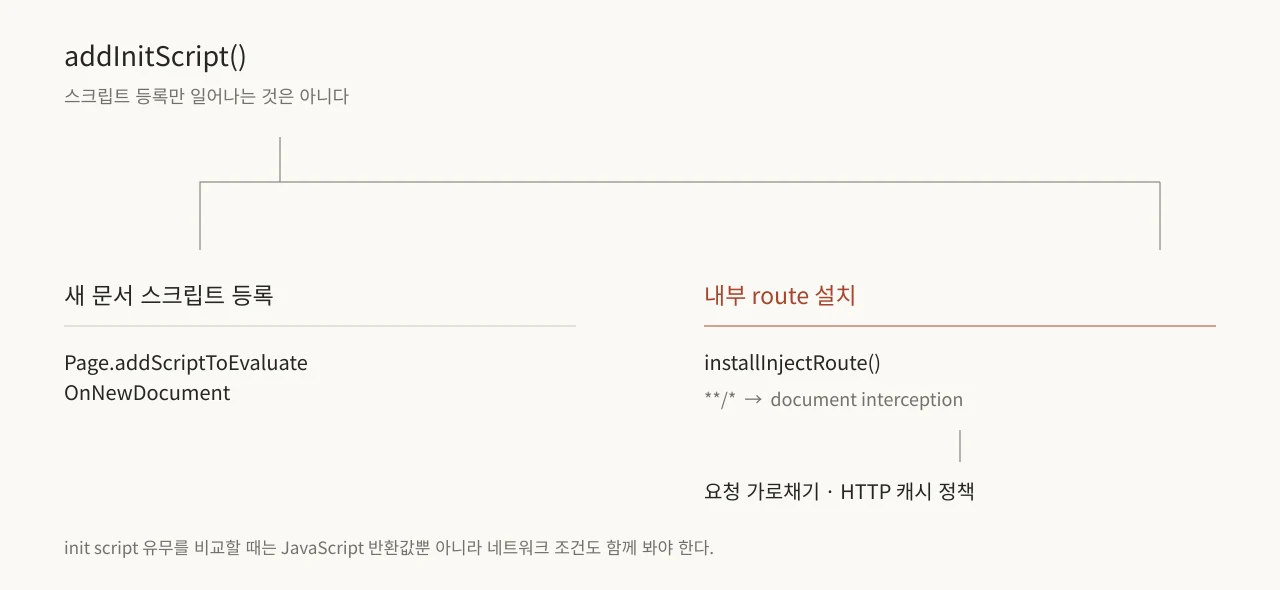
그래서 설정 몇 줄을 추가한 뒤 결과가 바뀌었다면, 덮어쓴 JavaScript 값만 비교해서는 부족하다. 캐시가 유지되는지, 같은 리소스를 다시 받는지, 문서 응답을 가로채는 경로가 달라졌는지도 봐야 한다. navigator.webdriver를 바꾸는 코드를 넣었으니 그 값 때문에 좋아졌거나 나빠졌다고 단정하기 어렵다. 확인해야 할 대상이 생각보다 넓어진다.
콘솔도 비슷했다. README의 ‘Console API 비활성화’를 페이지에서 window.console이 없어진다는 뜻으로 읽으면 곤란하다. 페이지의 console.log와 드라이버가 콘솔 이벤트를 수집하는 기능은 구분해야 한다. 프로젝트의 테스트 수정 목록에는 console, pageerror, worker, trace-viewer 관련 파일을 제외하는 항목도 있다. 이것만으로 해당 기능이 전부 동작하지 않는다고 말할 수는 없지만, 평소 쓰던 디버깅 수단이 그대로 남아 있다고 가정하기도 어렵다.
Patchright를 쓰지 말아야 한다는 이야기는 아니다. 다만 import만 바꾸면 된다는 설명 뒤에는 이런 차이가 있었다. 내가 추가한 설정과 내가 사용하는 관찰 도구까지 포함해 동작을 이해해야 한다. 페이지가 실패한 것인지, 드라이버가 이벤트를 가져오지 못한 것인지도 따로 확인해야 한다.
브라우저 안쪽에서 값을 바꾸는 쪽으로
Camoufox가 눈에 들어온 것은 그다음이었다. Patchright가 Chromium을 제어하는 드라이버 쪽에 개입한다면, Camoufox는 Firefox 자체에 패치를 적용한다. 반환되는 브라우저 정보까지 직접 제어하려는 것이다. 예를 들어 navigator.platform을 다루는 C++ 패치에는 이런 분기가 있다.
if (auto value = MaskConfig::GetString("navigator.platform")) {
  aPlatform.Assign(NS_ConvertUTF8toUTF16(value.value()));
  return;
}
JavaScript에서 프로퍼티를 덮어쓴 다음 원래 값처럼 보이게 만드는 대신, 브라우저 내부 getter가 설정값을 반환하게 한다. 실제 코드에는 context별 값 조회와 전역 설정 fallback이 있고, WorkerNavigator에 대한 패치도 따로 있다. 페이지의 navigator 하나만 바꿔놓고 worker 쪽에서는 다른 값이 나오는 식의 문제를 브라우저 내부 경로에서 다루려는 접근이다.
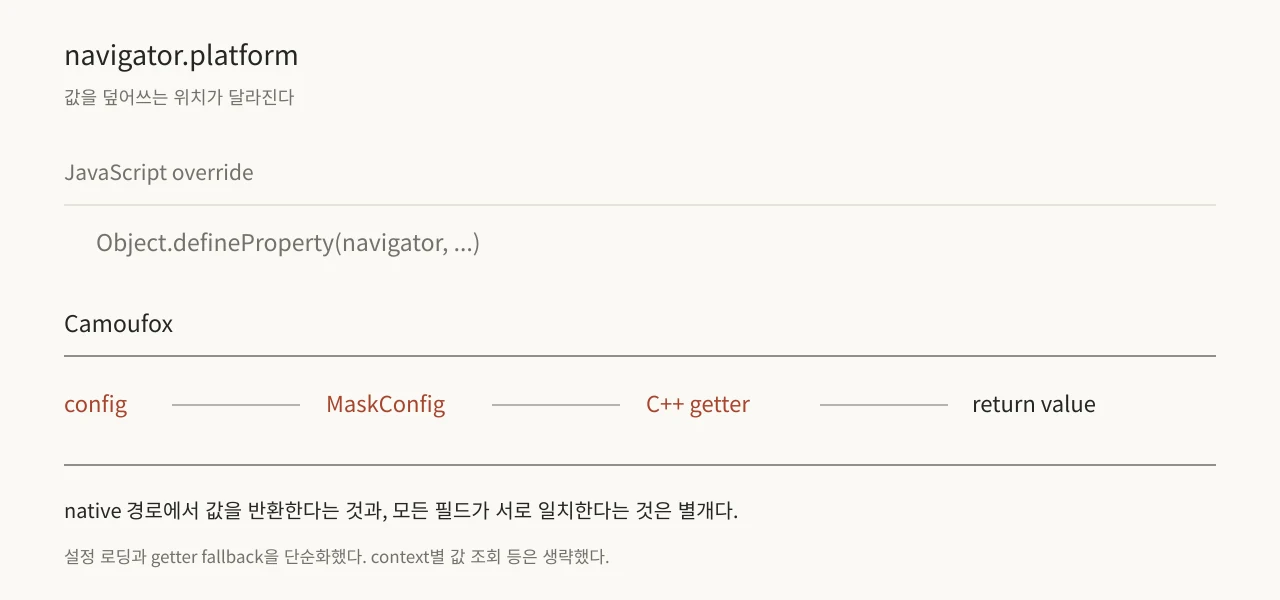
설정 로딩과 getter의 연결만 나타낸 그림이다. 모든 지문 필드의 정합성을 보장한다는 뜻은 아니다.
물론 C++에서 반환한다고 현실에 없는 장치 조합까지 자연스러워지는 것은 아니다. GPU 이름을 바꿨다고 실제 렌더링 하드웨어가 바뀌지는 않는다. HTTP 요청의 User-Agent, 페이지와 worker가 보고하는 환경, WebGL 기능과 실제 출력이 서로 얼마나 맞는지는 계속 확인해야 한다. 값이 어디에서 나오는지와 그 값들이 함께 타당한지는 따로 남는 문제다.
이 부분에서는 Camoufox의 설명도 그대로 받아들이기 어려웠다. 공식 사이트에는 BrowserForge 기반 설명이 남아 있지만, 조사한 main은 2026년 9월의 전환 커밋 이후 fpgen을 사용한다. 문서에 나온 import를 지금 소스의 설명에 가져오면 버전이 섞인다. Python 패키지 버전, 내려받은 Firefox 빌드, 설명을 읽은 커밋을 따로 적어야 하는 이유다.
지문 정합성을 다루는 coherence.py도 마찬가지였다. 수리 함수는 가능한 규칙을 적용한 뒤 남은 위반을 반환한다. 조사한 Python launch 경로에서는 이 결과를 debug 모드에서 출력하지만, 그 지점에서 모든 위반을 거부하고 새 지문을 다시 뽑지는 않는다. README의 정합성 설명을 ‘불가능한 조합은 언제나 차단된다’고 이해하면 실제 구현보다 강한 기대를 하게 된다.
직접 설정을 넣으면 내가 다시 불일치를 만들 수도 있다. HTTP 쪽 User-Agent 설정과 navigator.userAgent의 우선순위가 다르고, GeoIP로 들어가는 일부 timezone과 locale은 setdefault라 기존 수동값을 보존한다. 자동으로 맞춰준다는 옵션을 켰으니 내가 넣은 값까지 모두 정리되리라고 생각해서는 안 된다. 옮겨간 뒤에도 설정을 적게 유지하고, 필요한 값을 하나씩 확인하려는 이유다.
| 살펴본 부분 | Patchright | Camoufox |
|---|---|---|
| 주로 수정하는 곳 | Chromium을 제어하는 Playwright 드라이버 | Firefox와 Juggler, native API |
| 기존 환경 | Chrome을 유지하기 편함 | Firefox 동작과 호환성 확인이 필요함 |
| 페이지 전역 조회 | main world 선택 인자 | main_world_eval과 mw: |
| 내가 추가로 관리할 것 | 계측·route·실행 컨텍스트 차이 | 브라우저 빌드·지문 설정의 일관성 |
Camoufox로 옮긴다고 실행 세계에 대한 고민이 없어지는 것도 아니다. Juggler 쪽에는 Firefox의 Cu.Sandbox를 사용하는 코드가 있고, 기본 평가에서는 페이지의 전역이 그대로 보이지 않을 수 있다. 페이지 상태가 꼭 필요하면 해당 호출만 main world로 보낸다.
from camoufox.sync_api import Camoufox

with Camoufox(main_world_eval=True) as browser:
    page = browser.new_page()
    page.goto("https://example.com")

    # 이 전역을 정의한 페이지에서 사용하는 조회 예시다.
state = page.evaluate("mw:window.__APP_STATE__ ?? null")main_world_eval=True는 모든 평가를 main world로 바꾸는 옵션이 아니다. mw:가 붙은 호출을 그쪽으로 보내는 기능이다. 해당 구현은 이 경로의 handle 반환과 element·JS handle 인자도 제한한다. 직렬화할 수 있는 값을 짧게 읽는 것과 복잡한 객체를 계속 붙들고 조작하는 것은 구분해야 한다. 기존 코드가 페이지 전역이나 handle에 얼마나 의존하는지부터 확인해야 옮기는 비용도 가늠할 수 있다.
쿠팡에서 막혔다면
결국 남는 질문은 이것이다. 그래서 쿠팡에서는 무엇이 달라지는가.
지금 확인한 근거만으로 어느 쪽이 현재 쿠팡을 더 잘 통과한다고 말할 수는 없다. Akamai 공식 문서부터 요청 특성, 브라우저 상호작용, 행동 탐지를 서로 다른 계층으로 설명한다. 쿠팡의 특정 경로가 그중 어떤 설정을 사용하는지도 이 자료만으로 알 수 없다. 드라이버에서 줄인 신호가 문제였다면 Patchright의 수정이 의미가 있겠지만, 다른 조건에서 거절됐다면 브라우저를 바꾸는 것만으로는 답이 나오지 않을 수 있다.
먼저 구분할 것은 어디에서 막혔는지다. 첫 document부터 403인지, 문서는 열렸는데 상품 데이터를 가져오는 요청만 실패하는지, HTTP 200인 챌린지 화면을 성공으로 읽고 있는지에 따라 볼 것이 달라진다. 현재 문서가 실행되기도 전에 거절됐다면 그 문서에 주입할 JavaScript만 더하는 것은 순서가 맞지 않을 수 있다. 그렇다고 이전 세션에서 수집된 신호까지 관계없다는 뜻은 아니다.
나는 이 단계에서는 가능한 한 브라우저 조건을 그대로 두고 싶다. UA만 바꾸거나 헤더를 복사하지 않고, 불필요한 init script도 빼는 쪽이다. 이미지와 script, iframe을 먼저 차단하면 초기화에 필요한 요청까지 끊고 나서 그 실패를 탐지 문제라고 오해할 수 있다. 대역폭 최적화는 정상 흐름이 확인된 다음에 할 일이라고 생각한다.
세션도 마찬가지다. 요청마다 새로운 프로필을 만들거나 IP를 바꾸면 어느 조건이 달라졌는지 설명하기가 더 어려워진다. 반대로 쿠키를 복사하면 같은 세션을 재현했다고 생각하기도 쉽다. 하지만 별도 HTTP 클라이언트로 옮기면 TLS·HTTP 구현과 헤더, 인증 상태가 달라질 수 있다. 쿠키만 같다고 브라우저가 하던 요청까지 같아지는 것은 아니다. _abck 같은 이름이 보인다는 이유로 성공을 판정하는 것도 피해야 한다.
이때의 완료 조건은 적어도 다음 정도는 필요하다. 아래 코드는 진단 흐름의 예시이며, selector는 실제로 확인한 대상으로 바꿔야 한다.
const response = await page.goto(target, {
  waitUntil: 'domcontentloaded',
  timeout: 30_000,
});

const status = response?.status();
if (!response || status >= 400) {
  throw new Error(`navigation failed: ${status ?? 'no response'}`);
}

const title = await page.title();
if (/access denied|verify you are human|robot check/i.test(title)) {
  throw new Error('possible challenge page');
}

await page.locator(successSelector).first().waitFor({
  state: 'visible',
  timeout: 15_000,
});
제목 검사만으로 모든 챌린지를 가려낼 수는 없다. 여기서 한 번 더, 읽어낸 상품 ID와 가격 같은 필수 값이 유효한지 검사해야 한다. 브라우저 프로세스가 정상 종료됐거나 HTML을 받았다는 사실만으로 수집이 끝난 것은 아니다. 마우스를 곡선으로 움직이게 만드는 것보다 이런 판정부터 제대로 두는 편이 먼저라고 생각한다.
거절됐을 때 계속 재시도하는 것도 피하려 한다. 쿠팡 개발자센터는 OpenAPI의 반복 오류와 임시 차단을 설명하며 약 10분간 요청을 멈추는 방안과 circuit breaker를 안내한다. 웹사이트의 모든 403이 10분 뒤 풀린다는 뜻으로 가져다 쓸 수는 없지만, 막힌 요청을 그대로 쏟아붓는 것이 좋은 대응이 아니라는 점은 참고할 만하다. 여러 worker가 같은 출구를 쓴다면 한 프로세스만 쉬게 해서는 요청이 멈추지 않으니, 중단 상태도 함께 관리해야 한다.
Patchright에서 Camoufox로 옮기려는 이유는 이제 조금 분명해졌다. Patchright의 접근이 틀렸다고 생각해서는 아니다. 익숙한 Chrome을 유지하면서 드라이버의 흔적을 줄이는 방식에는 여전히 장점이 있다. 다만 내가 더 확인하고 싶은 부분은 브라우저가 무엇을 보고하고, 그 값이 어느 경로에서 만들어지는지에 가까웠다. 그 부분은 Firefox 내부까지 수정하는 Camoufox 쪽에서 살펴보고 싶어졌다.
대신 관리할 것도 늘어난다. Firefox 호환성을 확인해야 하고, 패키지와 브라우저 빌드가 맞는지 봐야 하며, 지문을 손댔다면 그 설정에도 책임을 져야 한다. 브라우저를 바꿨으니 이제 탐지되지 않을 것이라고 생각하지는 않는다. 우선은 설정을 덜 얹은 상태에서 시작해, 필요한 부분만 확인하며 옮겨가려 한다.
사실 클로드랑 GPT를 붙였을 때 개발과 동시에 프로덕션에 올리기가 쉬운 점도 있는 것 같다. DOM이 변경되지 않는 이상은 자동화가 깨질 염려도 거의 없고 말이다. 수정하는 것도 금방이다. AI Provider들이 모두 DOM 추적이 가능하다보니 개선도 빠르게 진행되서 우선 camoufox를 주로 사용해볼 것 같다.
서비스 성격이 아니고 빨리 반영이 되어야 하는 특성상 서버 PC에서 개발 및 운영, 배포를 하고 있는데 이 방식이 매우 편리한 것 같음.
참고한 자료
- Patchright: 권장 실행 구성, Runtime 초기화, 실행 컨텍스트, main-world 테스트, init script 등록, closed shadow root, 테스트 제외 항목
- Camoufox: native getter, fpgen 전환, 정합성 수리, 수리 결과 처리, HTTP UA 우선순위, GeoIP 설정, Juggler sandbox, main-world 제한
- Akamai: 공개 탐지 방식
- 쿠팡 개발자센터: OpenAPI 403 대응 안내